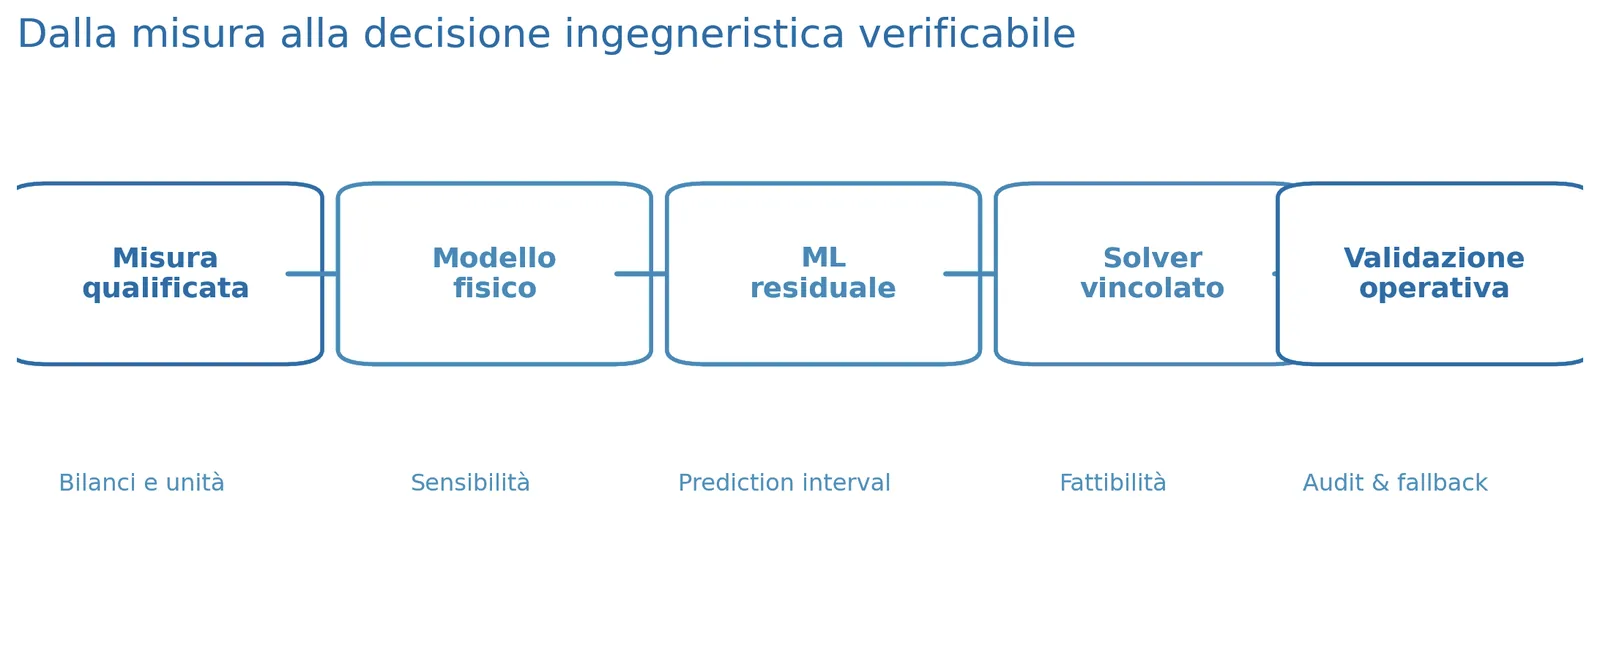
Due livelli: base e avanzato
In parole semplici
Immagina un’app che ti dice: «domani pioverà con probabilità del 70%». È un’informazione utile, ma non ti dice se prendere l’ombrello. Dipende da te: quanto ti costa bagnarti, quanto ti pesa portarlo in giro, dove devi andare. Lo stesso vale per i modelli di intelligenza artificiale: producono stime, non scelte.
Per questo, quando costruiamo un workflow, la prima domanda non è «quale algoritmo usiamo?», ma «quale decisione deve aiutare?». Una buona previsione collegata alla decisione sbagliata è inutile; una previsione modesta, ma ben collegata a una scelta concreta, può far risparmiare tempo, energia e denaro.
Per chi vuole andare a fondo
In ingegneria la catena completa è: misura qualificata, modello (fisico, statistico o ibrido), stima con incertezza, vincoli operativi, decisione, verifica. Ogni anello ha un suo modo di fallire: dati non validati, modello fuori dominio, intervalli troppo stretti, vincoli dimenticati, nessun controllo a posteriori.
Formalmente la decisione minimizza un costo atteso: per ogni azione possibile si pesa il costo di ciascuno stato del mondo con la sua probabilità stimata. Ne seguono due conseguenze pratiche. La prima: servono probabilità calibrate, non solo etichette. La seconda: la soglia di intervento dipende dai costi, non dall’accuratezza. Un modello con accuratezza più bassa ma probabilità affidabili può portare a decisioni migliori di uno «più preciso» ma sovraconfidente.
E[C(a)] = Σⱼ P(sⱼ | x) · C(a, sⱼ) → scegli l’azione a con costo atteso minimoDa ricordare: Prima si definisce la decisione e il costo dell’errore, poi si sceglie il modello.